如果你在本地用 ninfer 跑 Qwen3.8 28B 做多轮 Agent 对话,大概率见过这样的日志:
[req 11] done finish=tool_calls prompt=19180 gen=194 cache=13634 reuse=restore_turn_checkpoint ttft=4538ms
[req 15] done finish=tool_calls prompt=23952 gen=199 cache=13634 reuse=restore_turn_checkpoint ttft=8686ms
[req 19] done finish=tool_calls prompt=34692 gen=626 cache=23950 reuse=restore_turn_checkpoint ttft=9602ms
cache 只到一万多,prompt 已经三万四,TTFT 一路飙到 9.6 秒。明明 KV cache 就在显存里,为什么复用不上?答案藏在 ninfer 的一个语义开关里:preserve_thinking。从图看就更清楚了,图1为关闭preserve_thinking,图二为开启preserve_thinking。
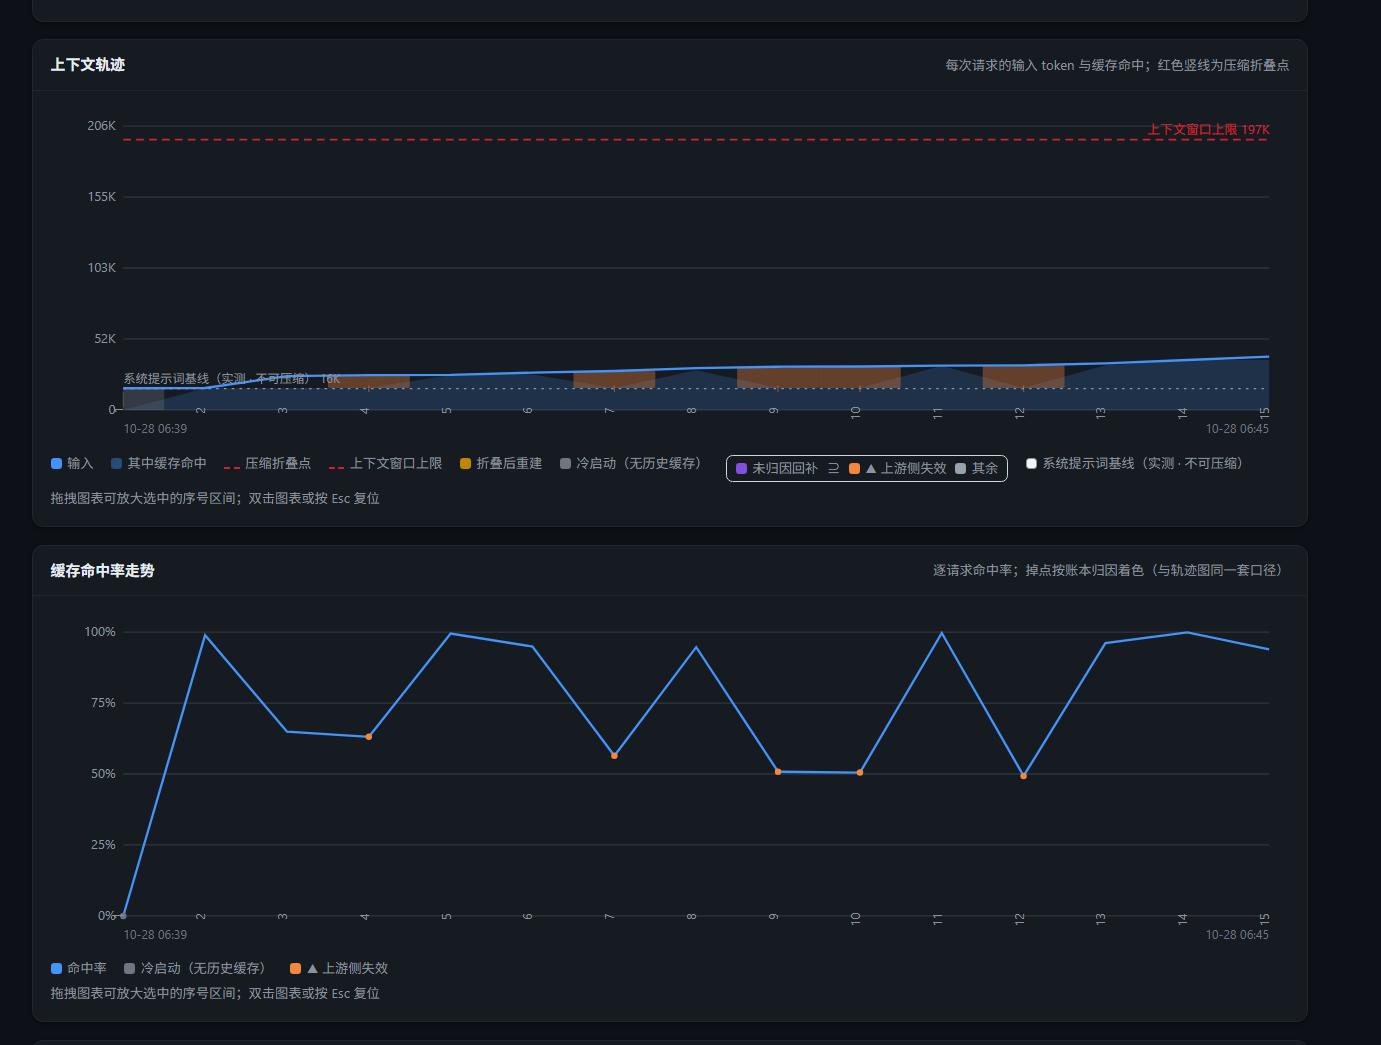
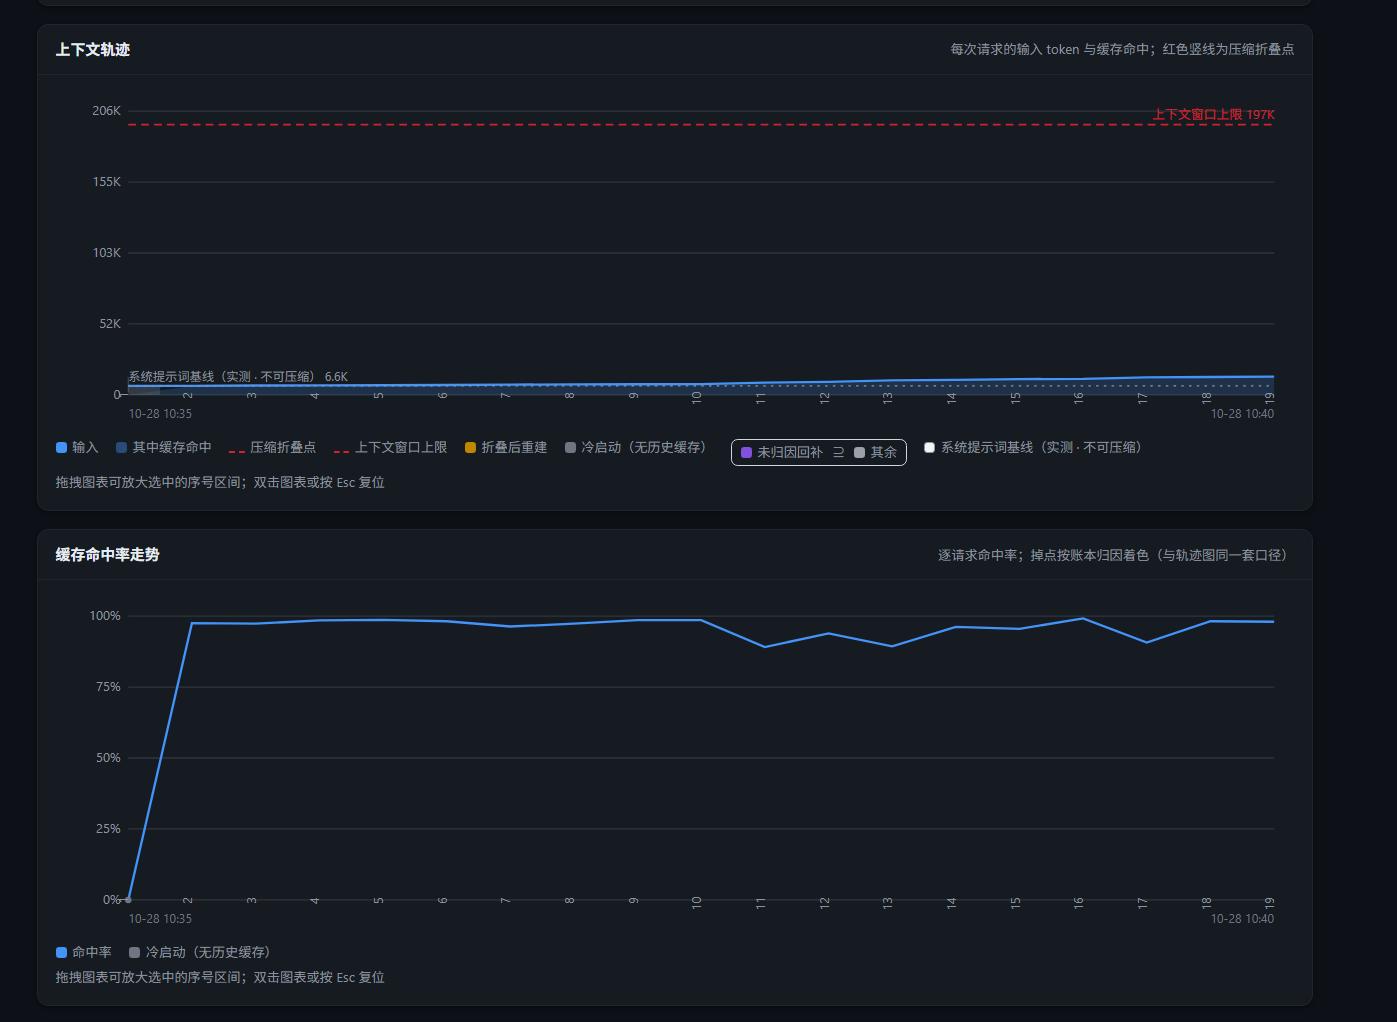
这篇文章拆解 ninfer 在本地跑 Qwen3.8 时,preserve_thinking=false/true 两种模式下 KV cache 复用机制的差异,以及为什么这个开关会直接决定你的首 token 延迟。
一、先搞清楚 ninfer 的缓存复用在复用什么
ninfer 的前缀缓存不是"只要能对上就复用"。它要求新请求渲染出的 token 序列,与缓存中的驻留序列在 token、位置、媒体、MTP/DFlash 状态上逐 token 精确匹配。
三个关键词:
- 驻留序列:某个 lane 上最近一次请求的完整 token 序列 = prompt + 已生成输出,末端就是前沿(frontier)。
- 检查点(checkpoint):在某个 turn 边界保存的状态快照,不只是 KV,还包括 GDN 线性注意力状态、hidden、MTP/DFlash 对齐位。ninfer 只认检查点位置上的前缀,不支持任意最长公共前缀复用。
- 复用路径:
append_at_frontier(直接接到前沿)、restore_turn_checkpoint / restore_response_checkpoint(回退到检查点再重算尾部)、full_reset(全算)。
一句话:ninfer 的命中不是"前缀有多长就复用多长",而是"能不能精确落在一个检查点上"。这个检查点放在哪,就是 preserve_thinking 要决定的事。
二、什么叫 turn "闭合"
Qwen3 的对话模板在渲染历史时,有一条逐消息规则:
keep_thinking = preserve_thinking || (i > last_query_index)
i 是 assistant 消息下标,last_query_index 是最后一条真实 user 消息的位置。
- 开放 turn(最后一条 user 之后的 assistant):推理内容恒保留,跟开关无关。这就是当前正在生成的回合。
- 闭合 turn(后面又出现了新的 user 消息的 assistant):
preserve_thinking=false 时,整个 <think>…</think> 块被剥掉;true 时保留。
注意:这里的"闭合"纯粹是模板渲染时的位置判断,不是网络关闭、不是消息对象标记完成、更不是 KV 被释放。它只回答一个问题:这条 assistant 回复后面还有没有新的 user 消息。
三、两种模式的本质差异:检查点放哪
preserve_thinking 不是"缓存兼容位",它是语义开关。但它通过改变渲染结果,间接决定了检查点的位置,从而决定下一轮走哪条复用路径。
| 放置点 |
false |
true |
| 历史中开放 turn 的 assistant |
a_opener 之后放 TurnClosure(prologue 之前) |
不放 |
| 生成 prompt |
a_opener + prologue P,TurnClosure 在 P 之前 |
a_opener + prologue P,ResponseReplay 在 P 之后 = 完整 prompt 末端 |
结构不变量很清楚:
false:检查点落在「assistant opener 之后、prologue 之前」——即旧 turn 推理即将开始、新 prompt 即将分叉的那个点。true:检查点落在「完整 prompt 末端、含确定性 prologue」——即整个 prompt 的末尾。
检查点永远落在"新旧 prompt 即将分叉"的边界上。 放得越靠后,能复用的越多;但能不能落到那里,取决于下一轮渲染的序列是否还与它逐 token 一致。
四、走读:1+1 和 1+2
设 enable_thinking=true。turn 1 问「1+1=几」,模型生成推理 R1 和回答 B1(「2」);turn 2 问「1+2=几」。记号:U=user 块,A=assistant opener,P=prologue,T=turn 结束定界。
turn 1(两种模式相同)
P1 = [U1][A][P]
冷启动 full_reset,生成 R1、</think>、B1。驻留序列变成:
[U1][A][P][R1][</think>][B1]
检查点:
false → F1 = [U1][A] 之后(P 之前)true → F1' = [U1][A][P] 之后(P1 末端)
turn 2,false
客户端重发历史,闭合 turn 的推理被剥掉:
P2 = [U1][A][B1][T][U2][A][P]
planner 两级判定:
- 完整前沿匹配?P2 在第一个 A 之后立刻分叉(驻留接
P R1…,P2 接 B1 U2…)→ 不匹配。
- 检查点前沿匹配?P2 的前
|F1| 个 token [U1][A] 与驻留相同 → 匹配。
→ restore_turn_checkpoint,复用基 = F1。
| 区段 |
处理 |
[U1][A] |
命中,KV 复用,GDN/MTP/DFlash 状态从 checkpoint 恢复 |
[P][R1][</think>][B1][T] |
trim 掉,零 FLOPs。R1 的 KV 不再被任何检查点引用 |
[B1][T][U2][A][P] |
全新 prefill |
为什么 B1 必须重算? 因为驻留序列里 B1 的 attention "看到"过 R1,它的 K/V 编码了对 R1 的依赖;新 prompt 里没有 R1,同一个 B1 的 K/V 是另一个数。KV 是完整前缀的函数,不能混用。
turn 2,true
客户端带着 R1 重发:
P2 = [U1][A][P][R1][</think>][B1][T][U2][A][P]
前提:R1 重新分词后逐 token 一致。
此时 P2 前缀 = 驻留序列的前 p + o − 1 个 token(p 是 P1 长度,o 是 turn 1 输出长度,−1 是被 withholding 的 stop token)。→ append_at_frontier,复用到驻留前沿,只重 prefill [T][U2][A][P]。R1 的 KV 全量复用。
如果 R1 重新分词漂移了呢? 前沿失配,回退到 F1'([U1][A][P] 末端)匹配 → restore_response_checkpoint,复用 = parent_prompt,重 prefill 归一化后的整条响应 + 新输入。
一张表看清两种模式
|
false(默认) |
true |
| turn 2 路径(round-trip 稳定) |
restore_turn_checkpoint |
append_at_frontier |
| turn 2 路径(round-trip 漂移) |
不受影响,仍 restore_turn_checkpoint |
restore_response_checkpoint |
| R1 的 KV 是否复用 |
否 |
稳定时是,漂移时否 |
| 模型是否"看到" R1 |
否(不在声明 prompt 里) |
是(它是 prompt 的一部分) |
| 每轮 prompt 增长 |
+B1 + U2 |
+R1 + </think> + B1 + U2(历史思考逐轮累积) |
| 命中对漂移的鲁棒性 |
强 |
弱 |
一个容易被忽略的观察:false 模式对 BPE 漂移是鲁棒的,因为它的检查点落在 A 之后,早于一切可能漂移的生成内容。true 模式把检查点推到 prompt 末端,换来了更高的命中上限,但也把"回传必须逐 token 一致"变成了硬前提。
五、为什么 false 模式下推理的 KV "不该"命中
这不是引擎做不到,是做了就错。三条理由:
1. KV 是完整前缀的函数。 第 1 层起,一个 token 的 K/V 由它之前的全部内容决定。驻留序列里 B1 的 KV 编码了对 R1 的 attention;新 prompt 没有 R1,B1 的 KV 就是另一个值。所以合法复用边界是分叉点,不是最长公共 token 前缀的末端。
2. 线性状态是累积的。 GDN 的线性注意力状态是前缀的累积函数,"到 B1 为止但不含 R1"的状态没有任何地方存过,唯一途径是重放尾部。
3. 输出必须是声明 prompt 的函数。 如果隐藏的推理 KV 留在上下文里,输出就依赖服务端的内部残留状态——同一份请求文本,在进程重启前后、缓存驱逐前后会得到不同结果。缓存副本必须与全新计算一致。
所以 TurnClosure 检查点放在 assistant opener 之后、prologue 之前,不是巧合,而是这个场景下合法最长前缀的精确位置。planner 已经把能命中的都命中了。
六、代价与选择
|
false |
true |
| 每闭合一个 turn 的代价 |
重 prefill 小尾巴(实测几十 token 量级) |
稳定时 0;漂移时重 prefill 整条响应 |
| 上下文 |
精简,思考不累积 |
历史思考逐轮累积,prompt 持续变长 |
| 适用负载 |
常规多轮对话(默认) |
需要模型跨轮看见上一轮思考的负载 |
Qwen3.8 本地跑 Agent 多步工具循环,属于典型的"需要跨轮复用思考"场景。false 的每轮小尾巴代价在短轮次里不明显,但在工具链里会被放大——你看到的那三行 restore_turn_checkpoint、TTFT 从 4.5 秒涨到 9.6 秒,就是 false 在长会话里的累积代价。
换成 true 后,路径确实从 restore_turn_checkpoint 切到了 restore_response_checkpoint,命中率从 56%–71% 提到了 90%–96%。但故事没结束。
七、一个真实的坑:true 也会 append 失败
这是很多人在本地跑 ninfer 时会踩的坑。看这组日志:
|
req 9 |
req 10 |
| prompt |
103,659 |
115,175 |
| gen |
10,999 |
1,210 |
| cache |
99,799 |
103,659 |
| 路径 |
restore_response_checkpoint |
restore_response_checkpoint |
已经开了 preserve_thinking=true,但 req 10 的 cache 精确停在 req 9 的 prompt 末尾,req 9 生成的 10,999 个 token 一个都没 append 上,整段重算,TTFT 冲到 16.3 秒。
原因就是上面说的:true 模式的 append_at_frontier 依赖客户端回传的 assistant 消息(thinking + tool_calls + 工具结果)与生成时逐 token 一致。任何字节级差异——thinking 格式、tool_calls JSON 的字段顺序、空格、工具结果被截断——都会让前沿失配,退化成 restore_response_checkpoint。
所以 true 不等于稳定 append。 它把命中上限推高了,但把"回传字节稳定"的责任交给了客户端。这是 ninfer 在本地 Agent 场景下最容易被低估的一点。
八、给本地部署的几条实践建议
-
Agent 长链场景显式开 preserve_thinking=true。 默认的 false 服务的是通用短轮次对话,在工具循环里会频繁回退到 TurnClosure,TTFT 会被拉高。
-
保证回传字节稳定。 开了 true 之后,客户端回传的 assistant 消息必须与原生成逐 token 一致。thinking 块不要改写、tool_calls JSON 不要重新序列化、工具结果原样回传。
-
看日志时区分 reuse= 路径。 append_at_frontier 是理想路径,restore_response_checkpoint 是 true 模式下漂移的兜底,restore_turn_checkpoint 是 false 模式的常态。看到 restore_response_checkpoint 且 cache 只到上一轮 prompt 末尾,就说明生成内容没复用上。
-
注意 prompt 增长。 true 模式下历史思考逐轮累积,长会话的 prompt 会持续变大。如果显存吃紧,要在"命中率"和"上下文体积"之间做取舍,而不是无脑开 true。
-
模式切换不会断缓存。 ninfer 的精确前沿和匹配检查点在模式翻转后仍可复用,planner 会用 ReclassifyExisting 或 DeferCapture 处理 kind 不一致的情况,不需要为了切模式而重启。
结语
preserve_thinking 看着像个小开关,实际上决定了 ninfer 把检查点放在哪、下一轮能不能 append、推理的 KV 是复用还是变成孤儿。它背后是一条清晰的正确性边界:KV 是完整前缀的函数,合法复用只能发生在分叉点,而检查点就是那个分叉点的精确位置。
在本地用 ninfer 跑 Qwen3.8 28B 做 Agent,理解这条边界比调任何参数都重要。false 和 true 没有绝对的优劣,只有"用命中率换 prompt 体积"还是"用 prompt 体积换命中率"的取舍。而真正决定你 TTFT 的,往往不是开关本身,而是开关背后那条回传字节是否逐 token 稳定的链路。