机器:2× Tesla V100-SXM2-16GB(sm_70,单卡 15.86GB 可用)+ 30.9GB 系统内存,Windows,ComfyUI v0.37.0。
模型:Comfy-Org/Qwen-Image-2.1 官方 repack,约 37.8GB。
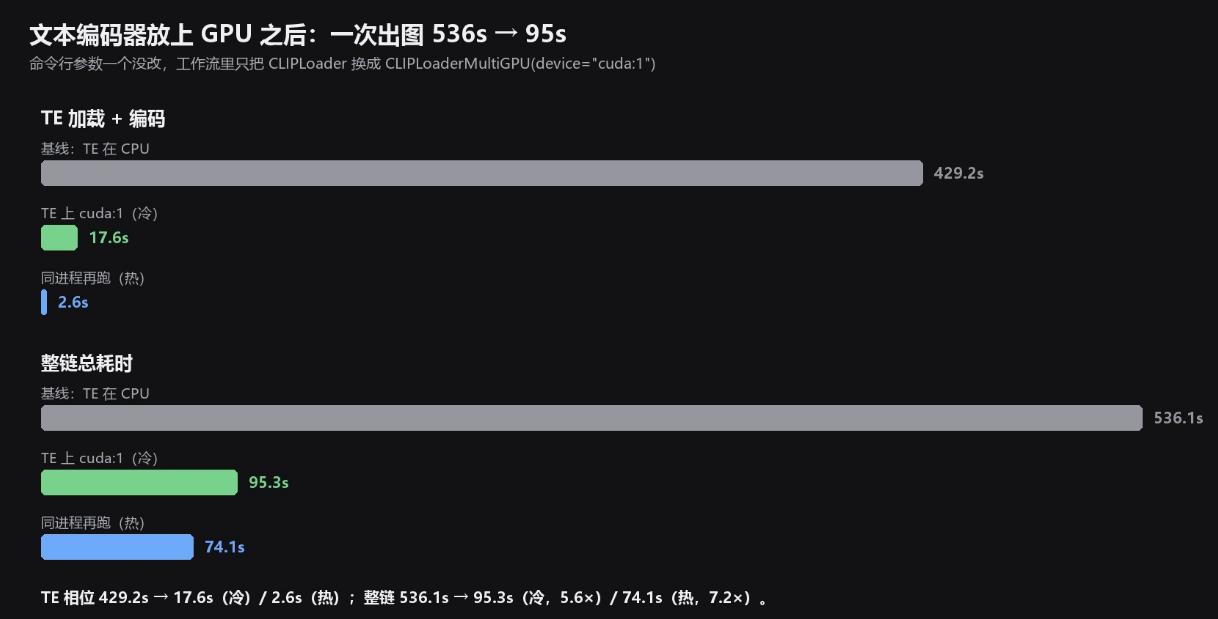
结论:能跑,质量好,中文渲染零错字。官方工作流不能照抄——本机要改启动参数、编码器节点、UI 文件顶层字段三处。改完一次出图从 536s 降到 95s。
一、先说结论
| 项 |
结果 |
| 采样速度 |
25 步 1024² 69.4s(2.78 s/it) |
| 一次出图(冷) |
官方原样 536.1s → 改完 95.3s(5.6×) |
| 一次出图(同进程热态) |
74.1s |
| 显存 |
GPU0 峰值 10954MB / GPU1 峰值 8330MB,各留约 5GB |
| 中文文字 |
「夏日冰爽特惠」「限时7折 · 全国包邮」全对,与 bf16 档目视无差 |
| 官方工作流能否直接用 |
不能。三处要改(启动参数、编码器节点、UI 文件顶层字段) |
瓶颈一开始根本不在采样,在文本编码器。它被钉在 CPU 上,编码一次 427 秒,采样才 70 秒。
二、装了什么
5 个文件,走 hf-mirror:
| 文件 |
目录 |
大小 |
qwen_image_2.1_int8_convrot.safetensors |
models/diffusion_models/ |
7.26GB |
qwen_image_2.1_bf16.safetensors |
models/diffusion_models/ |
14.23GB |
qwen3vl_8b_w4a8.safetensors |
models/text_encoders/ |
6.31GB |
qwen3vl_8b_int8_convrot.safetensors |
models/text_encoders/ |
9.35GB |
qwen_image_2.1_vae_bf16.safetensors |
models/vae/ |
0.68GB |
模型本体是 7B 视觉 DiT(32 层单流)+ Qwen3-VL-8B 文本编码器 + 16 通道 VAE。原生支持 2048²,支持 RGBA 输出和最多 10 张参考图。
ComfyUI 从 09-14 的提交 git pull 到 c194dd0(v0.37.0,含 Qwen-Image-2.1 支持),依赖同步升到 comfy-aimdo 0.5.5 / comfy-kitchen 0.2.35。
选 int8 还是 bf16:两个档采样同速(2.78 vs 2.80 s/it),int8 只多花在加载期的反量化。默认用 int8,显存省一半(7.26GB vs 14.23GB)。V100 没有 int8 张量核,这条路本来也赚不到速度。
许可证是 Qwen Research License,禁商用。
三、部署路上撞到的三堵墙
1. 起服务不带 --disable-cuda-malloc,第一个分配就炸
现象:提交任何任务,KSampler 初始化时 sigmas.to(device) 抛 CUDA error: operation not supported。
排查过程把七条路都走了一遍:单独加载 DiT + KSampler 初始化通过;真实权重上卡通过;完整 VAE→DiT→KSampler 顺序通过;--disable-all-custom-nodes 干净服务仍然崩;--disable-async-offload、--fast-disk 也照崩。最后在异常分支里直接 torch.empty(8, device="cuda:0"),在 worker 线程里就报 NOT_SUPPORTED,锁定在分配器。
根因:cudaMallocAsync 的内存池在 Windows WDDM 上不成立(cuMemCreate 返回 NOT_SUPPORTED),worker 线程里第一个走缓存分配器的分配必爆。
这个坑启动脚本的注释里早就写着。这次踩上纯属手动起服务时没照抄 bat 的完整参数。
顺带撤回一条冤案:排障中怀疑过的 --fast-disk、--disable-async-offload 和自定义节点补丁全部无罪——当时所有测试都被 malloc bug 污染。终验配置保留它们,只加 --disable-cuda-malloc。
2. 官方 CLIPLoader 没法把文本编码器放到指定显卡
--lowvram 档下,文本编码器落回 CPU,这是官方的既定行为,不是 bug:
nodes.py:1015 里 device 枚举写死 ["default", "cpu"],选项里没有 cuda;load_clip() 对 device 只做一件事:device == "cpu" 就 load_device = offload_device = cpu;- 于是落到
text_encoder_device():--lowvram 且 dynamic vram 不可用时走 else: return cpu。
main.py --help 的原文写得很明白:lowvram "makes the text encoders run on the CPU"。日志逐字印证:
[MultiGPU Core Patching] text_encoder_device_patched returning device: cpu
[INFO] CLIP/text encoder model load device: cpu, offload device: cpu, dtype: torch.float16
代价是 427 秒编码一次,而且 prompt 不变才吃缓存。
3. 界面工作流打不开:「无法在 xxx.json 中找到工作流」
生成的 UI 工作流拖进界面直接报错。根因是一条静默的异常链:
- 前端打开文件走
getWorkflowDataFromFile → getDataFromJSON,其中 isApiJson(e) 的实现是 Object.values(e).every(v => v.class_type);
- 生成器写出的顶层是
"id": null,对 null 取属性抛 TypeError: Cannot read properties of null (reading 'class_type');
- 该异常被
catch { resolve(undefined) } 吞掉;
- 整个文件被判定「不是工作流」→ 弹 toast「无法在 xxx.json 中找到工作流」。
对照实验排掉了其他可能:同页面里 H3 的工作流文件(id 是 UUID 字符串)正常解析;两份文件 JSON.parse 都成功;逐字符比对无差异——差异只在 id 的值。
修法:顶层 id 写 str(uuid.uuid4()),校验器加一条「顶层任何值为 null 即 FAIL」。
这里还有个更值得记的教训。最初的验证脚本是 app.loadGraphData(wf) 直接喂对象,它绕过了 getWorkflowDataFromFile → isApiJson → getDataFromJSON 整条链,漏掉了这个 bug 还报了通过。UI 工作流验收必须走前端真实文件路径(headless Chrome 打 #comfy-file-input),单参数直喂是假验证。
四、改了什么:两个节点,命令行零改动

改动就两处,都在工作流里:
CLIPLoader → CLIPLoaderMultiGPU device="cuda:1"
VAELoader → VAELoaderMultiGPU device="cuda:1"
MultiGPU 能破局的原因:wrappers.py:522 override_class_clip 给节点加了一个可选 device,执行时先 set_current_text_encoder_device() 翻掉模块全局量,再调原版 loader,于是原版内部那个 text_encoder_device() 返回 cuda:1。
device 必须显式写 cuda:1。MultiGPU 的默认值是 devices[1],也就是 cuda:0,会和 DiT 撞卡:实测 GPU0 峰值本来就有 10954MB,再加编码器的 6019.50MB 等于 16.97GB,超过 15.86GB 上限,必 OOM。
效果:
| 节点 |
基线(原版) |
改后(冷) |
同进程再跑(热) |
| 编码器加载 |
2.1s |
14.5s |
缓存 |
| 编码器编码 |
427.1s |
3.1s |
2.6s |
| KSampler 25 步 |
101.8s¹ |
74.0s |
69.8s |
| 整链 |
536.1s |
95.3s |
74.1s |
¹ 基线的 KSampler 101.8s 比改后多了约 28s,只测过一次、未复现,不当结论用(猜测是 CPU 上常驻的那 6GB 编码器占了内存、拖累 lowvram 的流式加载)。
编码器相位 429.2s → 17.6s(冷)/ 2.6s(热)——相对热态是 164 倍。整链 5.6×(冷)/ 7.2×(热)。
画质没有退化,这一点是量过的:同配置两次独立运行逐像素完全相同(max|Δ| = 0、100% 像素一致),说明这条管线是确定性的;在此前提下,「编码器在 CPU」与「编码器在 cuda:1」两次出图的差异是 mean 0.6997/255、灰度相关 0.99837——和「换 DiT 精度(bf16↔int8)」的 0.4922/255 同阶。1:1 原尺寸裁切比过水珠纹理和玻璃高光,无马赛克、无撕裂、无网格。
命令行一个参数都不用改,沿用 lowvram 档,只去掉 --fp16-unet。
--fp16-unet 为什么必须去掉:Qwen-Image-2.1 的 supported_dtypes 只有 bf16/fp32,没有 fp16。它和 H3 的启动档因此互斥——两个工作流不能待在同一个服务进程里,换模型必须换档重启。
五、多 GPU 的真相:第二张卡只上了一次班
这是最容易误判的地方。看监控会发现 GPU1 大部分时间是空的,采样全程毫无动静。
这不是配置错误。 ComfyUI 的采样器本身只收一个 device——traceback 里写得很清楚:
comfy/samplers.py:1463 → sample(self.model, noise, positive, negative, cfg, self.device, ...)
参数里只有一个 self.device,每次执行都打 [MultiGPU Runtime] Using runtime device cuda:0。所以 DiT 全程在 GPU0,GPU1 只在文本编码那几秒被碰一下。
GPU1 看着「空」还有两个叠加原因,都不是故障:
- 执行缓存:prompt 没变,编码节点被跳过,日志里就不会出现加载编码器的记录;
- OOM 会逐卡清空:
execution.py 命中 OOM → unload_all_models() → model_management.py:2121 遍历 get_all_torch_devices() 逐卡 free_memory(),cuda:1 上的编码器被一起清掉。清掉之后 prompt 仍然没变,它就不会回来,直到换 prompt。
所以真实时间线是这样的:第一次跑编码器上 GPU1 → 后面几次常驻 → 某次 OOM 把它清空 → 靠缓存不重载,GPU1 一直空 → 换 prompt 才回填。
那要不要让 GPU1 参与采样? 不用。DT2 的官方口径是 "as if cuda:0 had 8GB more VRAM",donor 在 "somewhere slower"——借容量,不借算力,权重仍要逐次搬到计算卡上。DiT 只有 7.18GB,一张卡本来就装得下,拆开只是多付 NVLink 搬运。判为纯亏。
真正压垮 GPU0 的是「大画布 + 多参考图」,不是少了哪张卡。多图编辑那次 OOM 落在 comfy_kitchen/backends/eager/quantization.py:1075 的 int8_linear → torch.cat,一次要 1.14GiB;当时 GPU0 已分配 12.76GiB,另有 1.69GiB「reserved 但未分配」的碎片(Windows 上 expandable_segments 不可用)。把画布降到 512×512 后 1.80 s/it 通过。
顺手把 VAE 也挪到 cuda:1 值不值?值,但别夸大。DiT 加载时可用的显存从 11243.90MB 涨到 13997.39MB(+2753MB),加载期宽松多了;但采样峰值并没有降(15218MB,94.2%),它正好夹在旧配置两次 OOM 的 reserved 14796 / 15590MB 之间。所以这是「少了一个常驻占用 + 加载期多出余量」,不是 OOM 根治。真要修还是降画布、减参考图。
(另外这个对照不严密:旧日志那次服务已经跑过 4 个任务、有累积状态,新服务是冷启。+2753MB 里有多少来自挪 VAE、多少来自服务更干净,没剥开。)
六、文生图工作流
官方 t2i 拓扑和编辑拓扑不是一回事。 官方 image_qwen_image_2_1_t2i.json 里是 EmptyLatentImage(width, height) 直供 KSampler,TextEncodeQwenImage21 的第三个输出 latent 压根没接线(links=None)。
所以纯文生图不需要编辑模板那套 switch 技巧,resolution 参数也不参与。画布自己填,只要边长是 32 的倍数;官方默认 1MP,原生支持 2K。
官方参数是 25 步 / cfg 1.0 / euler / simple。cfg 是 1.0,所以 negative prompt 无效,这是模型蒸馏 CFG 后的正常表现。提示词用英文——官方模板自带的示例就是英文时装大片 prompt。
画布与耗时标定(25 步,实测):
| 画布 |
比例 |
出图耗时 |
GPU0 峰值 |
| 1024×1024 |
1:1 |
72.5~74.9s |
10318MB |
| 1344×896 |
3:2 |
86.7~88.9s |
10614MB |
| 1024×1280 |
4:5 |
94.7~98.8s |
10802MB |
| 1536×864 |
16:9 |
98.8~100.9s |
10840MB |
| 1024×1344 |
3:4 |
102.7~105.0s |
10922MB |
跑了一批 20 场景 × 2 变体验证稳定性:

40/40 成功,零失败、零重试、零 OOM,整批 wall 计时 62.9 分钟。GPU0 峰值 67.2%、GPU1 62.5%,各留约 5GB,40 连跑峰值不漂移。这是一条充裕档,不是擦边档。
批量里踩到两个坑,都值得记:
- 断点续跑的过滤键写错,已完成的活被重跑。重跑时 prompt 和 seed 全同,2.1 秒就返回了——执行缓存命中,采样一步没发生,差点被当成「通过」。测显存或测质量,每次提交必须唯一 seed。
- 拼版缩略图必须等比内接,不能
resize((w, h)) 硬拉。这批混了 5 种比例,第一版总览把 3:2 和 16:9 拉成竖幅,画幅直接变形。
七、编辑工作流:编辑、多图、去背共用一个拓扑
一体化工作流,14 节点 15 连线,拓扑与官方 image_qwen_image_2_1_image_edit 模板的 subgraph 内部逐节点一致,只把文本编码器换成 CLIPLoaderMultiGPU(device="cuda:1")。
官方那个 ComfySwitchNode 就是模式开关,不需要为每种玩法单独建工作流:
switch = false(默认):画布 = 编码出的 latent,尺寸跟随 <image1> → 编辑 / 多图参考;switch = true:画布 = EmptyLatentImage 的宽高 → 自定义尺寸 / 文生图。
两个参数语义容易搞错:
TextEncodeQwenImage21.resolution 是总像素预算(面积),不是宽也不是高。它保持长宽比。默认 1024,原生 2048,设 0 = 不缩放、保持参考图自身尺寸(官方模板就是从 0 起的)。实测 resolution=1024 配一张 1024×637 的参考图(比 1.607),输出是 1312×800。- 参考图最多 10 张,提示词里写
<image1>…<image10>,image_1 是编辑目标。
多图编辑的产物:

编辑档和文生档的显存压力不是一个量级。 1312×800 画布 + 3 张参考图,GPU0 峰值 15218MB,占 94.2%——擦边。前几次侥幸通过,第 5 次提交撞爆。跑到同一个配置下用不同 seed 压测(1001/1002/1003),三轮都是 255s 左右、峰值完全一致、零 OOM,但产物的两两像素差是 69.9 / 63.4 / 43.8(/255),说明 seed 真生效、不是缓存回放。
这里有个反面教材:第一版「三连跑」是废数据——提示词和 seed 全同,run2/run3 各 0.02 秒直接命中执行缓存,采样一步都没发生。这种「通过」毫无意义。测显存余量必须换 seed 或改任一上游输入。
去背不需要独立工作流。 同一份拓扑,提示词写 Remove the background, and output a PNG image,resolution=0,挂一张参考图,就完事了:

实测口径:输出 1024×640 RGBA,alpha = 0 占 71.25%,真正柔边(alpha 16~239)只占 1.06%,alpha = 255 占 13.74%,中间 240~254 那部分是亚像素抖动、本质不透明。关键是 alpha=0 区域的 RGB 均值是 [0.4, 0.2, 0.5],近黑——换到绿幕或新底色上不会泛白边。冷加载 138.7s。
顺带一提,resolution 用 0 的时候输出尺寸跟着参考图走,但会被对齐取整:输入 1024×637,输出 1024×640。
八、整机崩了两次:提交内存打满
09-21 傍晚服务连续崩了两次,都是整机硬复位(Kernel-Power 41 ×2,BugcheckCode=0,无蓝屏),不是服务自己退。
根因不是供电,是提交内存打满。决定性线索有三条:服务日志尾部是 OSError: 页面文件太小,无法完成操作 (os error 1455),也就是 ERROR_COMMITMENT_LIMIT;同一窗口里 DWM 反复退出重启 7 次;崩点固定在编辑工作流的 Requested to load QwenImage21 之后——正是加载 DiT 的那一瞬间,CPU 侧 mmap + staging + 反量化的提交峰值点。
账是这样:CommitLimit = 30.91GB 物理 + 15.87GB 页面文件 = 46.41GB。46.41GB 是本机提交上限的硬墙,和「物理内存 30.9GB」一样,是所有大加载场景的前提。
崩后检查硬件:gpu_health 全好,双卡各空闲 15.85GB,NVLink 12/12 ACTIVE,P2P 正常。
九、别踩的坑(速查)
| 别做 |
理由 |
给 Qwen-Image-2.1 加 --fp16-unet |
supported_dtypes 只有 bf16/fp32 |
去掉 --disable-cuda-malloc |
worker 线程首个缓存分配必报 operation not supported |
指望 --enable-dynamic-vram |
实测闭合:comfy-aimdo 0.5.5 仍报 WDDM init failed (1) |
| 靠 DT2 让 GPU1 参与采样 |
借容量不借算力,DiT 本来装得下 |
| 在 sm_70 上找注意力加速 |
Sage / Flash / INT8 / 核心稀疏全无后端 |
用 nvidia-smi 取显存 |
本机间歇性 NVML 初始化失败,用 pynvml |
| 拿缩略图判伪影 |
缩略拼版走样会伪造伪影,只能 1:1 原尺寸裁切 |
| 测余量时复用同一个 seed |
执行缓存命中,采样一步不跑也报「通过」 |
十、边界
未测的:2048² 原生档、RGBA 透明图(作为输入)、圆圈/蒙版局部编辑。多图编辑那条「VAE 挪卡是否真的消掉了 OOM」仍未定案——要严格定案得在同一服务里做 A/B(先新配置跑 N 次,再切回 cuda:0 跑 N 次),没做。
本文只覆盖部署、双卡分工、文生图与编辑工作流这一段。之后的采样加速实验(换采样结构、加蒸馏 LoRA 之类)是另一条线,另文再写。
工作流文件现状说明:仓库里 workflows/ui_importable/qwen_image_21_t2i_1024_ui.json 后来被另一批实验改动过(步数与节点),已不是本文描述的 25 步原版;编辑那一份 qwen_image_21_t2i_edit_multiref_ui.json 的拓扑未变。以文件为准,本文描述的是部署期的状态。